每一家公司都需要自己的 Skills Marketplace
我现在越来越觉得,每一家公司最终都需要自己的 Skills Marketplace。
这个判断不是从“要不要再做一个 AI 工具”开始的,而是来自我在数据分析 Agent 和团队 Skills 体系里的实际问题。
AI 生成 SQL、图表和报告的速度已经很快,但它并不会自动知道一家公司内部的指标口径、数据边界、工作流程和历史经验。很多时候,限制 Agent 的不是模型能力,而是它能不能在执行任务时拿到正确的业务 context。
当这些 context、流程和判断标准开始被整理成 Skills 后,新的问题也随之出现:Agent 怎么找到合适的 Skill?团队怎么分发和更新它?一次使用失败后,问题怎么回到维护者那里,而不是消失在一段聊天记录里?
但这里的 Marketplace,不是一个让人逛的 prompt 商店,也不是一个把各种 AI 小工具摆在一起的目录。更准确地说,它是一套公司内部的 AI-native 知识基础设施:让 Agent 在真实工作里找到正确的上下文,使用正确的流程,并把失败反馈回知识的维护者。
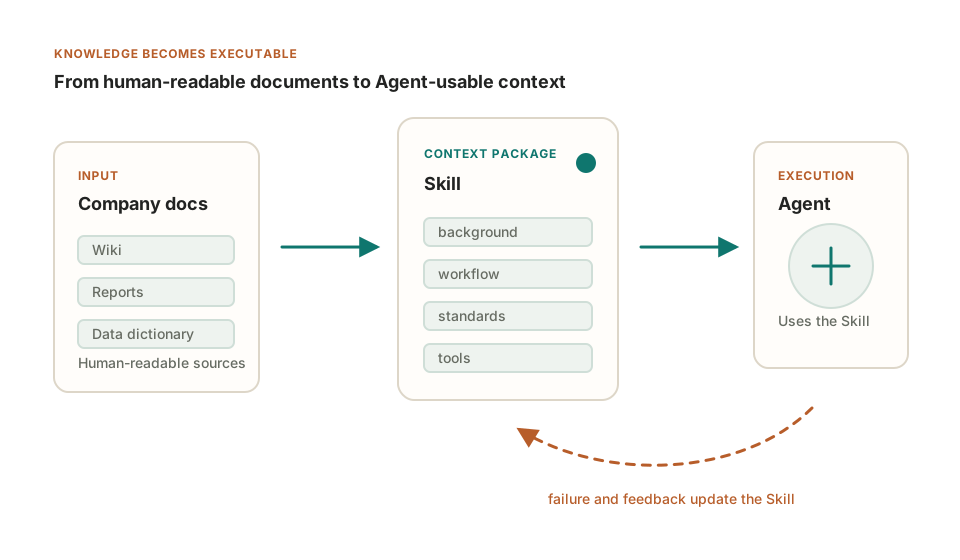
过去,公司的知识主要沉淀在文档里。新人入职会读飞书、wiki、历史报告、数据字典,问同事某个指标怎么取,某个字段到底是什么意思,某类分析应该遵守什么标准。
但当工作开始从“人自己执行”变成“人让 AI 或 Agent 协助执行”时,知识的承载位置也会变化。
知识不能只停留在人读的文档里。它也需要变成 AI 执行任务时可以调用的上下文。
Skill 是什么
我对 Skill 的暂时定义是:
Skill 是面向具体工作场景的高浓度上下文包。它把完成某类任务所需的背景知识、工作流、判断标准、工具入口和注意事项,沉淀成 AI 可以调用的知识资产。
它不是普通文档。
普通文档主要给人读。Skill 是给 Agent 在执行任务时加载的。
它也不是一次性的 prompt。
Prompt 通常服务于某一次对话或某一个任务。Skill 更像一个可维护、可版本化、可复用的工作知识单元。
一个类比是 Python package。
Python 本身是通用语言,但进入具体领域时,我们会用 pandas、scikit-learn、PyTorch 这样的 package。大模型也是类似的:它有很强的通用能力,但默认不知道每家公司内部的口径、流程、字段语义和历史判断。
Skill 就是 AI 时代的场景 package。
它告诉 Agent:这个场景应该怎么做,哪些信息必须知道,哪些错误要避免,什么时候应该调用工具,什么时候应该停下来问人。
为什么需要 Marketplace
如果一家公司只有一个 Skill,那不需要 Marketplace。
但真实情况很快会变复杂。
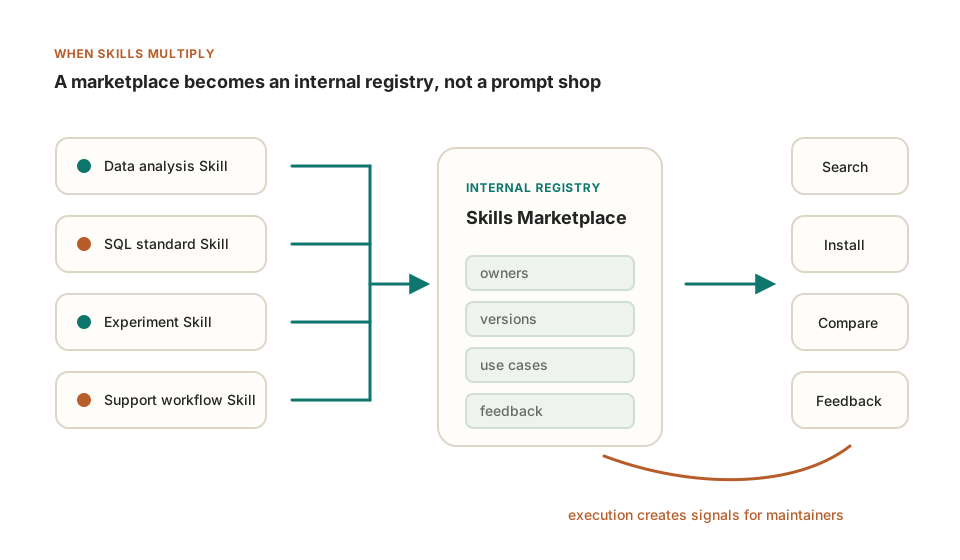
一家公司里可能会出现数据分析 Skill、实验分析 Skill、SQL 规范 Skill、代码 review Skill、客服工单 Skill、销售运营 Skill、内部工具使用 Skill。
这些 Skills 会由不同团队维护,有不同 owner、不同适用场景、不同版本,也会不断过时。
这时候,公司需要的不只是 Skills,而是一个内部的 registry / marketplace。
它至少要解决四件事。
第一是发现。
Agent 接到一个任务时,应该能判断自己是否缺少上下文,并搜索该用哪个 Skill。比如用户说“帮我查一下首购率”,Agent 应该意识到这不是一个普通 SQL 问题,而是一个公司内部指标口径问题。
第二是分发。
Skill 需要被安装、同步、更新到 Agent 能读取的位置。它更像 package manager,而不是一个静态知识库。
第三是比较。
公司内部经常有多个口径、多个版本、多个团队实践。Marketplace 应该让这些差异可见,让团队可以讨论应该合并、保留分叉,还是标记某个版本过时。
第四是反馈。
这是最重要的一点。Skill 不会一开始就完美。当 Agent 使用 Skill 失败时,这个失败不应该只停留在一次对话里。它应该变成结构化 feedback,回到 Skill creator 或 maintainer 那里,推动下一版迭代。
这就是 Skills Marketplace 和传统知识库最根本的区别。
传统知识库的目标是把知识存下来。Skills Marketplace 的目标是让知识进入执行,并在执行中被修正。
最小形态是什么
Skills Marketplace 的第一版不需要是一个大而全的平台。
它至少需要三个彼此连接的部分:
- 一个给人使用的 registry,让团队可以发布、查找、理解和维护 Skills。
- 一个给 Agent 使用的入口,让它能在任务中搜索、安装、更新和调用 Skills。
- 一条反馈链路,把缺失规则、错误口径和失败案例送回明确的 maintainer。
这三部分连起来,才形成真正的闭环:人把经验整理成 Skill,Agent 在工作中使用,真实结果再推动 Skill 更新。至于榜单、评论、推荐和复杂的社区机制,都可以等这个闭环跑通后再考虑。
一个具体例子
假设一个新来的数据分析师问 Agent:
帮我查一下首购率。
如果没有 Skill,Agent 可能会生成一个看似合理但口径错误的 SQL。它不知道公司内部首购率怎么定义,不知道应该用哪张表,不知道订单时间字段应该取哪个,也不知道哪些平台和订单状态要过滤。
有 Skills Marketplace 之后,理想流程应该是:
- Agent 判断这是“数据分析 / 商业指标取数”场景。
- Agent 通过 CLI 搜索相关 Skill。
- 它找到
company-data-analysis。 - 它安装并读取这个 Skill。
- Skill 告诉它首购率的标准口径、常用表、字段语义和 SQL 规范。
- Agent 生成 SQL,并说明自己使用了哪个 Skill 和哪个口径。
- 如果 SQL 执行失败,Agent 把失败原因反馈给这个 Skill。
- Skill creator 更新字段说明或示例 SQL。
下一次,所有使用这个 Skill 的 Agent 都会变得更好。
这个例子的重点不是“有一个网页可以看 Skills”。
重点是:公司的知识资产可以通过 Agent 的真实使用和真实失败持续迭代。
它不是什么
Skills Marketplace 很容易被误解成 prompt marketplace。
但 prompt marketplace 的核心是“人来浏览和复制提示词”。我说的 Skills Marketplace 不是这个。它更接近一个 internal registry:让 Agent 在任务中发现、安装、调用和反馈上下文。
它也不完全是 workflow marketplace。Workflow 更适合高度稳定、步骤固定的任务;Skill 更适合半结构化、探索性、需要专业判断的任务。
所以这个判断的重点不是网页长什么样,而是公司知识是否能从“人读文档”变成“Agent 可调用的工作上下文”。
这件事可能只是一个中间态
我不确定 Skill 会不会是最终形态。
如果未来模型长期记忆、企业知识检索、权限系统、工具调用和 workflow 都足够成熟,很多显式的 Skill 可能会被底层化。用户未必永远会感知到一个叫 Skill 的东西。
但我觉得这不影响现在做 Skills Marketplace 的意义。
因为当下的 AI work 正处在一个很明显的中间状态:
- 模型已经足够强,可以执行越来越多任务。
- 企业知识库还不是 AI-native 的。
- 很多工作流还不能被完全写死。
- 公司内部知识仍然散落在文档、表、代码、历史报告和人的经验里。
- Agent 需要一种低成本方式获得场景上下文。
Skill 是这个阶段最轻、最快、最可部署的知识单元。
而当 Skills 多起来之后,每家公司都会需要自己的 Marketplace。
不是为了让人逛。
而是为了让 AI 在真实工作中更快找到正确上下文,并让每一次失败都能推动组织知识资产变得更好。