Data Mama:为什么我们没有继续做一个完整的 Data Agent
2026 年 1 月初,我在 Solvely 开始搭建一个内部 Data Agent,早期叫作 Data Mama。
我们希望用户可以直接提出数据问题,由 Agent 理解需求、寻找业务上下文、生成并执行 SQL,再完成临时取数、漏斗分析和实验下钻。
第一版已经跑通了一部分流程,但我们最终没有继续把它做成一个完整的 Data Agent。
不是因为数据分析不适合使用 Agent,而是因为做到一半后,我开始意识到:我们真正应该建设的,可能不是另一个完整的 Agent,而是可以被不同 Agent 调用的数据分析能力。
问题从来不只是“不会写 SQL”
在开始这个项目之前,我和公司里一些经常使用 SQL 的同事聊过他们在数据分析中的实际困难。
大家真正缺少的通常不是 SQL 语法,而是:
- 不知道应该使用哪张表、哪个字段。
- 不确定不同团队使用的指标口径是否一致。
- 历史 SQL 很长,却没有说明背后的业务背景。
- 不知道数据的更新时间、适用范围和异常情况。
- AI 可以快速生成 SQL,但无法判断结果是否完整、口径是否可信。
AI 让 SQL 的生产速度变得越来越快,但数据分析的瓶颈没有因此消失。它只是从“怎么写 SQL”,转移到了“怎样获得正确的业务 context”。
如果 Agent 不知道公司的指标定义、数据边界和分析规范,它只会更快地生成一份看起来完整、实际可能错误的结果。
我们最初怎样设计 Data Mama
Data Mama 的第一版被拆成四层。
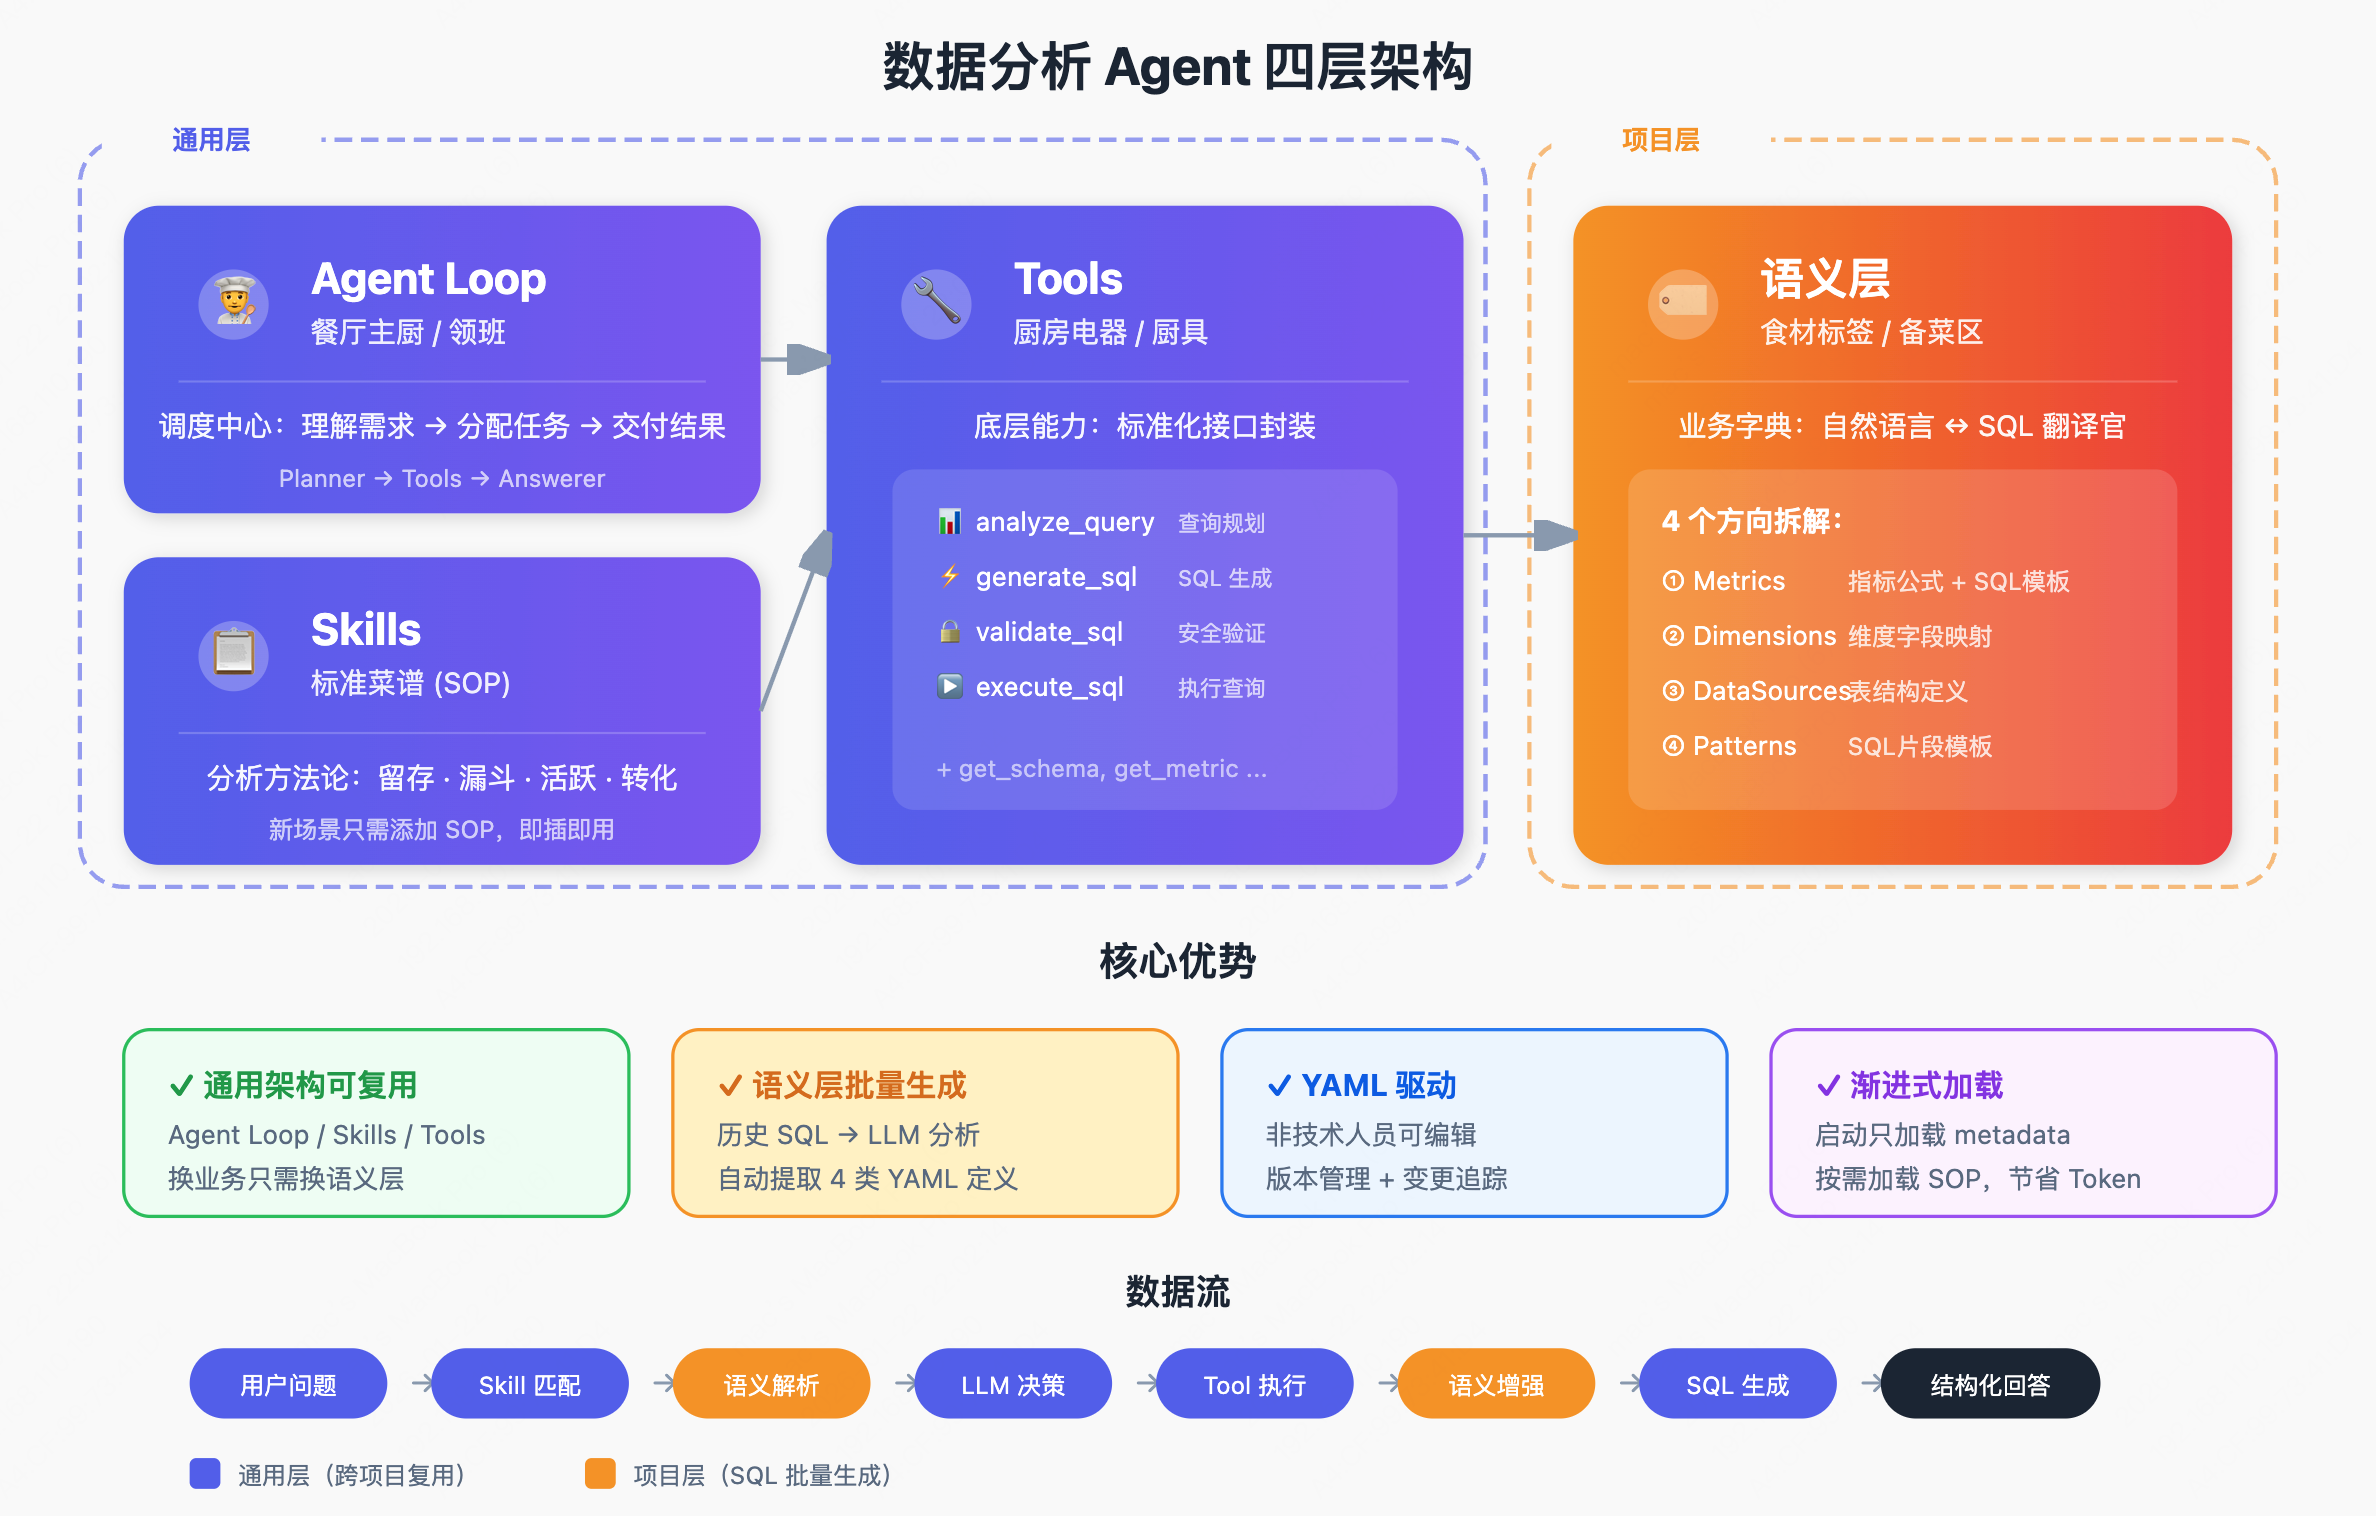
最上面是 Agent Loop。它负责理解用户的问题、拆解任务、选择工具并组织最终答案。
第二层是 Skills。我们尝试把留存、漏斗、活跃、转化等分析场景中的流程、判断标准和检查项整理成可以复用的方法。
第三层是 Tools,包括查询规划、SQL 生成、安全检查和查询执行。Agent 不需要直接处理所有底层细节,而是通过标准化接口完成任务。
最后是每个业务项目自己的语义层。它记录四类信息:
- Metrics:指标定义和 SQL 模板。
- Dimensions:维度与字段映射。
- Data Sources:可以使用的数据表及其结构。
- Patterns:可以复用的 SQL 片段和分析模式。
这些定义以 YAML 等可编辑形式维护,也可以尝试从历史 SQL 中提取。Agent 先加载少量 metadata,再根据任务逐步读取需要的 Skill、工具和业务语义,避免一次性把所有信息塞进 context。
这套设计解决的不只是自然语言转 SQL。它想把一次数据分析需要的业务知识、分析方法和执行工具组织成一个可以持续复用的系统。
为什么一开始想把所有流程放进 Data Mama
从产品设计上,我们最看重的不只是统一入口,而是把需求理解、任务拆解、上下文读取、SQL 执行和结果整理留在同一个系统里。
这样做有一个很明显的好处:我们可以看到 Agent 读取了什么信息、调用了什么工具,以及最后在哪一步出错。
有了完整的 Trace,就可以继续做 evaluations:
- 如果 Agent 不知道某个指标,就补充语义层。
- 如果它总是漏掉某项检查,就把规则沉淀进 Skill。
- 如果某个步骤反复执行,就把它封装成 Tool 或 API。
- 如果某类问题经常失败,就把真实案例加入评估集。
理想情况下,每一次失败都会推动系统下一次做得更好。
这也是把所有流程放进 Data Mama 最吸引人的地方:不仅可以完成任务,还可以观察和改进完整的工作链路。
我们后来发现,自己正在重做一套 Agent 系统
但随着项目继续推进,问题逐渐不再只是数据能力本身。
为了让 Data Mama 真正好用,我们还需要让它具备足够强的代码编写能力、长任务执行能力、上下文与状态管理,以及文件系统操作。
用户也不会只给 Agent 一句数据问题。他们可能会让它读取本地 Excel、处理 CSV、修改代码、生成文件,并把一个需要多步执行的任务持续做完。
这些能力如果都集成进 Data Mama,就意味着我们不只是在开发一个数据分析产品,而是在重新搭建一整套通用 Agent harness:
- 任务规划与状态管理。
- 长任务执行和错误恢复。
- 代码生成与运行。
- 文件系统和本地环境操作。
- Excel、CSV 和文档处理。
- 工具编排、权限与交互体验。
但 Codex 和 Claude Code 已经在持续建设这些能力,而且迭代速度很快。
当时它们还没有开放足够完整的 SDK,让我们直接复用其 Agent harness,再把自己的数据能力接进去。因此,我们面对的选择实际上是:要么接受能力边界,要么自己重新实现大量通用 Agent 基础设施。
这不是一个人或者一个小团队能够低成本完成的事情,也不是我们最有优势的部分。
用户已经在更好的 Agent 里工作
另一个重要背景是,Solvely 本身是一家非常 AI-native 的公司。
大家已经被鼓励使用 Codex 和 Claude Code,并逐渐把它们放进自己的日常工作流。它们不只是聊天工具,而是用户真正执行代码、操作文件和完成长任务的环境。
如果继续做一个独立的 Data Mama,我们不仅需要追赶这些工具的通用能力,还需要让用户离开已经熟悉、能力更强的 Agent,进入另一个相对封闭的界面。
即使 Data Mama 更了解公司的数据,它在代码能力、长任务和本地环境操作上仍然可能明显弱于用户原本就在使用的工具。
这让我开始重新思考系统的边界。
从完整 Data Agent 转向数据分析 Skills
我们最终阶段性停止了继续补齐 Data Mama 的 Agent runtime。
但 Data Mama 中真正有价值的部分没有消失。
我们保留并继续建设了公司独有的数据分析能力,包括:
- SQL 生成与检查。
- 数据质量检查。
- DataFrame 构建与处理。
- 统一指标口径。
- BigQuery、Dataform 和 Looker 相关流程。
- 漏斗、实验和商业化分析方法。
- 数据工具和标准化接口。
这些内容逐步被整理成数据分析 Skills,让它们可以进入 Codex 和 Claude Code 等成熟 Agent 的工作环境。
这样,我们不再需要自己维护完整的 Agent runtime。用户继续使用已经熟悉、而且不断进化的 Agent;我们则集中精力建设只有公司内部才拥有的数据、语义、流程和判断标准。
后来改变的不是数据能力由谁维护,而是任务在哪里执行。
指标口径、数据规范、分析方法、Tools 和 Skills 仍然由我们统一建设和维护;但具体的代码编写、长任务执行和文件处理,可以直接交给用户已经在使用的 Codex 和 Claude Code。
如果一定要概括,就是:
统一维护数据分析能力,在不同的成熟 Agent 中完成执行。
Data Mama 留下了什么
Data Mama 没有成为一个完整的数据分析产品,但它帮助我更清楚地理解了一个 AI 产品的系统边界。
一个垂直团队不一定需要拥有从模型到 Agent runtime 的所有层。真正需要自己建设的,是那些来自业务、数据和组织经验的独特能力;通用的代码执行、任务规划和文件操作,可以交给更成熟的平台。
所以 Data Mama 对我最大的意义,不是证明我们能从零做出一个 Data Agent,而是让我意识到:
我们阶段性放弃的不是 Data Agent,也不是 AI 数据分析,而是从零维护一整套通用 Agent harness。
与其把有限的精力用来追赶 Codex 和 Claude Code,不如把公司的数据分析能力做得足够准确、清楚、可复用,并让它们可以被不同的 Agent 调用。
这也是我们后来转向数据分析 Skills 的起点。